Dal cruscotto alla domanda: cambia il lavoro del manager
Per anni la maturità delle Service Operations è stata associata alla qualità dei dashboard: dati aggiornati, filtri coerenti, soglie visibili e qualche drill-down. Il problema è che il cruscotto risponde bene alle domande previste quando è stato costruito, mentre la gestione quotidiana vive di domande nuove. Perché ieri il service level è sceso? Quali code rischiano di mancare il target? Dove conviene intervenire prima del picco del lunedì?
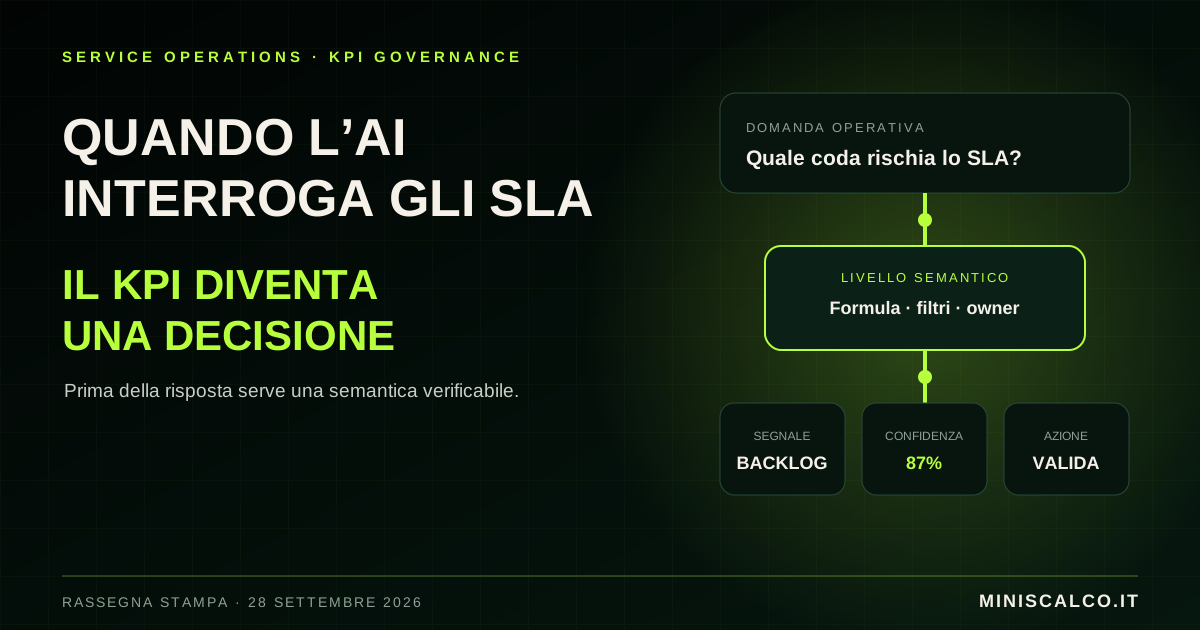
Il 21 agosto 2026 AWS ha annunciato per Amazon Connect Customer la possibilità di conversare con i dati operativi. Un manager può chiedere quali code siano candidate all’automazione; il sistema combina handle time e after-contact work, restituisce una lista prioritaria, un livello di confidenza e un impatto stimato. Non è soltanto un’interfaccia più comoda. È il passaggio da un sistema che mostra indicatori a uno che formula una lettura e suggerisce una decisione.
Per Service Desk e Digital Workplace il trend è rilevante anche oltre il contact center. Le fonti sono le stesse che alimentano una Service Review: volumi, tempi, backlog, qualità, self-service, valutazioni e capacità. L’AI riduce drasticamente il costo di interrogazione, ma proprio per questo aumenta il rischio di prendere decisioni rapide su metriche non governate.
Una risposta naturale non rende naturale il dato
La conversazione nasconde la complessità tecnica, non la elimina. Parole apparentemente semplici come risolto, abbandonato, riaperto o automatizzato possono avere definizioni diverse tra contratto, tool ITSM e report del fornitore. Se l’assistente sceglie una metrica tecnicamente disponibile ma semanticamente sbagliata, la risposta sarà fluida, precisa nei decimali e comunque inutilizzabile.
La documentazione AWS di Manager Assist dichiara l’accesso a oltre 150 metriche standard e personalizzate, con domande successive che permettono di scendere da un riepilogo alla singola coda, persona o fascia oraria. La potenza è evidente; la responsabilità è altrettanto chiara. Ogni KPI deve avere un nome, una formula, un perimetro, una frequenza, una fonte, un owner e regole di accesso comprensibili anche fuori dal team che lo ha creato.
Prima di introdurre una chat sui dati costruirei quindi un catalogo semantico minimo. Per ogni indicatore: cosa misura, cosa esclude, quale decisione abilita e quali distorsioni può produrre. L’AI dovrebbe citare metrica, intervallo e filtri utilizzati, non limitarsi alla conclusione. La fiducia nasce dalla possibilità di ricostruire la risposta, non dalla sicurezza con cui viene formulata.
Le metriche personalizzate diventano un prodotto da governare
Il secondo segnale è arrivato il 16 settembre 2026: AWS ha introdotto API per creare, descrivere, cercare, aggiornare e cancellare metriche personalizzate. Definire una metrica una volta e distribuirla in modo coerente tra code, team e ambienti riduce il classico proliferare di formule quasi uguali. Ma trasforma anche il KPI in un oggetto versionato, con un ciclo di vita simile a quello di una configurazione applicativa.
Questa logica è preziosa per i servizi in sourcing. Cliente e fornitore possono vedere lo stesso dato e attribuirgli significati diversi. Una definizione gestita tramite codice consente approvazione, versionamento, test e tracciabilità delle modifiche. Se cambia la formula del first contact resolution o l’esclusione dei ticket duplicati, la modifica deve avere una data di efficacia e una motivazione, altrimenti il trend storico perde confrontabilità.
Porterei quindi le metriche critiche sotto change control leggero: owner di business, custode tecnico, test su dati campione e registro delle versioni. Non serve burocratizzare ogni contatore. Serve proteggere gli indicatori che alimentano SLA, penali, capacity planning, valutazioni delle persone o decisioni di automazione.
Il rischio più sottile è automatizzare la diagnosi sbagliata
Una raccomandazione operativa produce valore quando collega un segnale a una causa plausibile e a un’azione reversibile. Se una coda manca il service level, aumentare la capacità può essere corretto; ma il problema potrebbe dipendere da routing, skill non aggiornate, indisponibilità di un sistema o domanda duplicata generata da un self-service inefficace. Correlazione e causa non sono intercambiabili.
Definirei tre livelli di risposta. Il primo è descrittivo: cosa è successo, con dati verificabili. Il secondo è diagnostico: quali fattori hanno contribuito, con confidenza e alternative. Il terzo è prescrittivo: quale azione viene proposta, con impatto, costo e criterio di rollback. L’AI può accelerarli tutti, ma l’autorizzazione deve restringersi man mano che cresce l’effetto della decisione.
Una query che riassume il backlog può essere autonoma. Una proposta di spostare operatori richiede conferma. Una modifica al routing o alla priorità di un servizio critico deve seguire le regole di change e lasciare evidenza. Il controllo umano non va aggiunto ovunque: va collocato dove una risposta diventa un’azione sul servizio.
Permessi e privacy devono seguire il dato fino alla conversazione
L’accesso conversazionale può rendere interrogabili dati che prima richiedevano competenze, report dedicati o autorizzazioni esplicite. La documentazione AWS chiarisce che Manager Assist eredita i permessi necessari a visualizzare metriche di utenti, code, routing profile, casi, valutazioni e test. È il principio giusto: la chat non deve diventare una scorciatoia intorno alla segregazione dei dati.
Nel Digital Workplace questo punto è delicato. Prestazioni individuali, aderenza, sentiment e valutazioni possono entrare nello stesso spazio analitico. Occorrono viste coerenti con ruolo e finalità, aggregazione quando il dettaglio non è necessario e log delle domande effettuate. Anche la risposta dovrebbe minimizzare i dati personali: indicare una tendenza di team prima di esporre nominativi.
Aggiungerei un controllo periodico sulle domande più frequenti e su quelle negate. Le prime mostrano quali decisioni mancano nei dashboard; le seconde rivelano bisogni reali o tentativi di superare il perimetro. Entrambe sono materia utile per service governance, sicurezza e relazioni con le persone.
Un pilota utile parte da cinque domande, non da centocinquanta metriche
Per provare il modello sceglierei cinque domande manageriali ricorrenti: rischio SLA nelle prossime ore, crescita anomala del backlog, domanda evitabile, cause di riapertura e opportunità di automazione. Per ciascuna definirei risposta attesa, fonti ammesse, metrica ufficiale, livello di dettaglio e azioni consentite. Poi confronterei il risultato con l’analisi di un service manager su un periodo storico.
Le misure del pilota dovrebbero includere tempo risparmiato, accuratezza, completezza delle citazioni, stabilità della risposta, falsi allarmi e percentuale di raccomandazioni accettate. Aggiungerei un indicatore spesso ignorato: quante volte la domanda rivela che il KPI disponibile non è adatto alla decisione. Anche questo è valore, perché rende visibile il debito informativo.
Il risultato desiderato non è un manager che smette di leggere i dati. È un manager che dedica meno tempo a recuperarli e più tempo a discuterne significato, priorità e conseguenze. Quando l’AI interroga gli SLA, il vero vantaggio competitivo non è la risposta immediata: è avere metriche abbastanza governate da poterle usare senza esitazione.
Fonti e approfondimenti
- AWS — Amazon Connect Customer now lets managers chat with their data, 21 agosto 2026 ↗
- AWS — Custom metrics APIs, 16 settembre 2026 ↗
- AWS — Manager assist capabilities ↗
- AWS — Metric definitions in Connect Customer ↗
- AWS — Get started with Manager assist ↗
Analisi e interpretazioni sono personali e non rappresentano le posizioni delle organizzazioni citate o del mio datore di lavoro.