Il ticket non passa più di mano: passa da un agente all’altro
Nel Service Desk siamo abituati agli inoltri: primo livello, gruppo specialistico, fornitore, applicativo. Ogni passaggio lascia almeno una coda, un assegnatario e un orario. Con gli agenti AI il trasferimento può diventare quasi invisibile. Un agente dialoga con il dipendente, ne coinvolge un secondo per verificare un ordine, un terzo per interrogare un sistema e poi ricompone la risposta. Per l’utente sembra una sola conversazione; operativamente è una catena di decisioni.
Il 19 settembre 2026 Amazon Connect ha documentato la collaborazione agent-to-agent durante un contatto, anche con agenti esterni e con modalità voce. Il segnale importante non è soltanto la capacità di far cooperare più modelli: è la scelta di rendere obbligatoria la tracciabilità di messaggi, chiamate agli strumenti, risultati e tempi. Se un endpoint esterno non invia i dati richiesti, la documentazione prevede che venga disabilitato per i nuovi contatti.
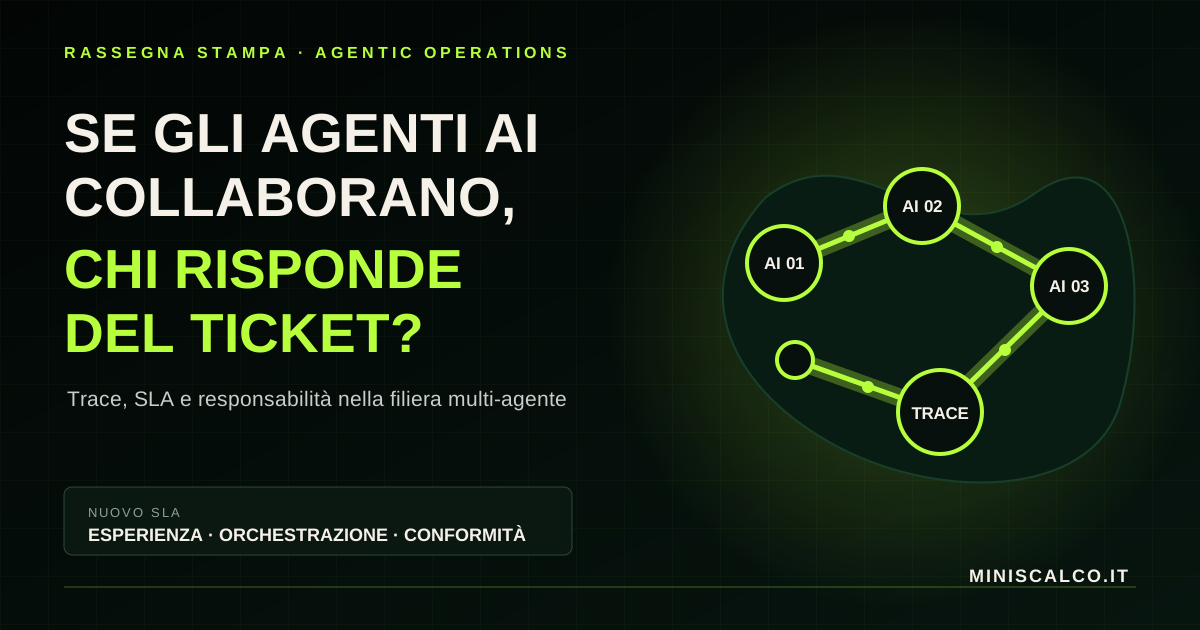
È una soglia interessante per tutto il mercato ITSM. Finché l’AI suggerisce una risposta, possiamo valutarla come assistente. Quando delega attività ad altri agenti, la governance deve assomigliare a quella di una filiera di servizio: responsabilità, evidenze, confini e continuità.
La risposta corretta non basta se non sappiamo come è nata
Una risposta può essere corretta per caso. Può derivare da un dato vecchio, da uno strumento non autorizzato o da una deduzione che domani cambierà con il modello. Nel supporto operativo conta il risultato, ma conta anche la possibilità di ricostruirlo. La nuova documentazione AWS richiede per ogni collaborazione input e output, tool call e relativi risultati, oltre ai tempi di inizio e fine di ogni span.
Questa non è telemetria ornamentale. Permette di rispondere a domande concrete: quale agente ha deciso di coinvolgere un collaboratore? Quale dato gli è stato passato? Quale sistema è stato interrogato? Dove si è accumulata la latenza? Il risultato è stato modificato prima di arrivare all’utente? Senza queste informazioni, il ticket chiuso resta una scatola nera e la root cause di un errore diventa un’opinione.
Per un service owner, la trace dovrebbe diventare parte del record operativo, collegata al contatto con un identificatore stabile e una retention coerente. Non serve esporre il ragionamento interno del modello; serve conservare fatti verificabili: richieste, risposte, strumenti, esiti, policy applicate, passaggi di controllo ed eventuale intervento umano.
Il nuovo SLA ha tre livelli
Se la conversazione è gestita da più agenti, misurare soltanto tempo di risposta e risoluzione è insufficiente. Propongo tre livelli. Il primo resta il risultato percepito: soluzione, chiarezza, effort richiesto al dipendente e riaperture. Il secondo riguarda l’orchestrazione: numero di deleghe, latenza di ogni passaggio, errori, fallback e trasferimenti all’operatore. Il terzo misura la conformità: completezza delle trace, uso di strumenti consentiti e rispetto del perimetro dati.
Questi livelli evitano un equivoco frequente. Un agente che coinvolge cinque specialisti può sembrare intelligente, ma essere lento, costoso e fragile. Uno che risponde subito può aver saltato una verifica necessaria. La qualità nasce dal compromesso tra esperienza, efficacia e controllo, non dal numero di agenti messi in scena.
Nel catalogo del servizio definirei quindi un budget di delega per intento: profondità massima, numero di handoff, tempo cumulato e costo accettabile. Le stesse note AWS indicano quote su collaboratori, profondità e trasferimenti per sessione e precisano che un solo collaboratore può essere attivo per turno. I limiti tecnici cambieranno; la disciplina manageriale dovrebbe restare.
Il fornitore dell’agente entra nella catena di servizio
Quando un agente esterno partecipa al ticket, il suo fornitore non vende più soltanto una capacità AI: entra nel modello operativo. Dovrà garantire disponibilità dell’endpoint, compatibilità del protocollo, qualità delle trace, gestione delle versioni, sicurezza dei dati e tempi di risposta. Sono elementi da portare nel contratto, non da lasciare alla buona volontà del team tecnico.
Il procurement dovrebbe chiedere portabilità delle evidenze, identificazione della versione del modello e degli strumenti, notifica delle modifiche, supporto all’audit e procedure di uscita. Se il collaboratore viene disabilitato perché non invia trace complete, deve esistere un fallback che non interrompa il servizio: ritorno all’agente principale, instradamento umano o risposta controllata.
C’è poi il tema della responsabilità. L’orchestratore deve rimanere accountable per ciò che restituisce all’utente, anche quando il dato arriva da un collaboratore. Delegare l’esecuzione non significa delegare la titolarità del risultato. Per questo ogni servizio dovrebbe avere un owner umano, una matrice RACI e soglie che impongano l’approvazione prima di azioni ad alto impatto.
Voce e omnicanalità rendono l’errore più difficile da correggere
Nel testo un passaggio incerto può essere riletto; nella voce la conversazione scorre e l’utente attribuisce continuità a ciò che ascolta. Se un agente trasferisce la parola a un collaboratore, cambiano latenza, tono, capacità di interrompere e possibilità di restituire il controllo. Le limitazioni documentate oggi includono, in alcune modalità voce, l’assenza di handback audio durante il contatto: il collaboratore deve completare o escalare.
Per il supporto omnicanale questo impone test diversi dal chatbot. Bisogna misurare silenzi, sovrapposizioni, conferme su dati sensibili, comprensione delle identità e qualità dell’escalation. La trace tecnica va collegata alla trascrizione e agli eventi del contatto, così che un supervisore possa ricostruire non solo cosa è stato detto, ma quale agente aveva il controllo in quel momento.
Partirei quindi dal canale testuale e da attività dietro le quinte, senza far parlare subito il collaboratore con il dipendente. Quando tool call, ritorni, errori e fallback sono stabili, si può estendere alla voce. L’omnicanalità non è replicare la stessa automazione ovunque: è preservare responsabilità e qualità quando cambia il mezzo.
Una prova operativa in trenta giorni
Il primo pilota non richiede una costellazione di agenti. Basta scegliere un intento frequente e circoscritto, per esempio verifica dello stato di una richiesta o recupero di informazioni da un sistema specialistico. Un agente principale gestisce il dialogo; un collaboratore svolge una sola funzione; nessuna azione irreversibile viene eseguita senza controllo umano.
Prima del test definirei lo schema minimo della trace, i dati che possono attraversare il confine, il timeout, il fallback e cinque casi negativi: collaboratore indisponibile, risposta contraddittoria, tool fallito, trace incompleta e superamento del budget di delega. Su cento contatti confronterei risoluzione, effort, latenza, completezza delle evidenze, costi e riaperture con la baseline tradizionale.
La domanda finale non è quanti agenti possiamo collegare. È se, davanti a un errore, riusciamo a capire chi ha fatto cosa e a proteggere l’utente senza interrompere il servizio. La collaborazione tra agenti diventerà ordinaria quando smetterà di sembrare magia e inizierà a comportarsi come una filiera governata.
Fonti e approfondimenti
- Amazon Connect — Agent-to-agent collaboration, documentazione aggiornata 19 settembre 2026 ↗
- Amazon Connect — Observability for collaborating AI agents ↗
- Amazon Connect — Trace data requirements for external AI agents ↗
- Amazon Connect — Quotas and limitations for agent-to-agent collaboration ↗
Analisi e interpretazioni sono personali e non rappresentano le posizioni delle organizzazioni citate o del mio datore di lavoro.